数字人产品口播视频 Bot
运营在飞书群里发三样素材,Bot 交回一条可直接投放的产品口播视频。
问题
客户需要持续产出多款产品的口播短视频。制作要经过写脚本、做首帧、分段生成视频、剪辑拼接,每一步都要懂 AI 工具的人操作,运营同事很难独立完成。
做法
把整条制作链拆成「收素材 → 选画幅 → 首帧 → 脚本 → 分段生成 → 拼接交付」,每一步在飞书话题里让运营确认后再往下走,模型调用和剪辑都放到后台自动完成。
结果
Bot 在团队内部实际运行,生成了 15 个真实视频任务;支持 9:16 / 1:1 / 16:9 三种画幅和 8 / 15 / 30 秒三种时长,并完成了迁移到团队服务器的交接文档和运营上手指引。
为什么做
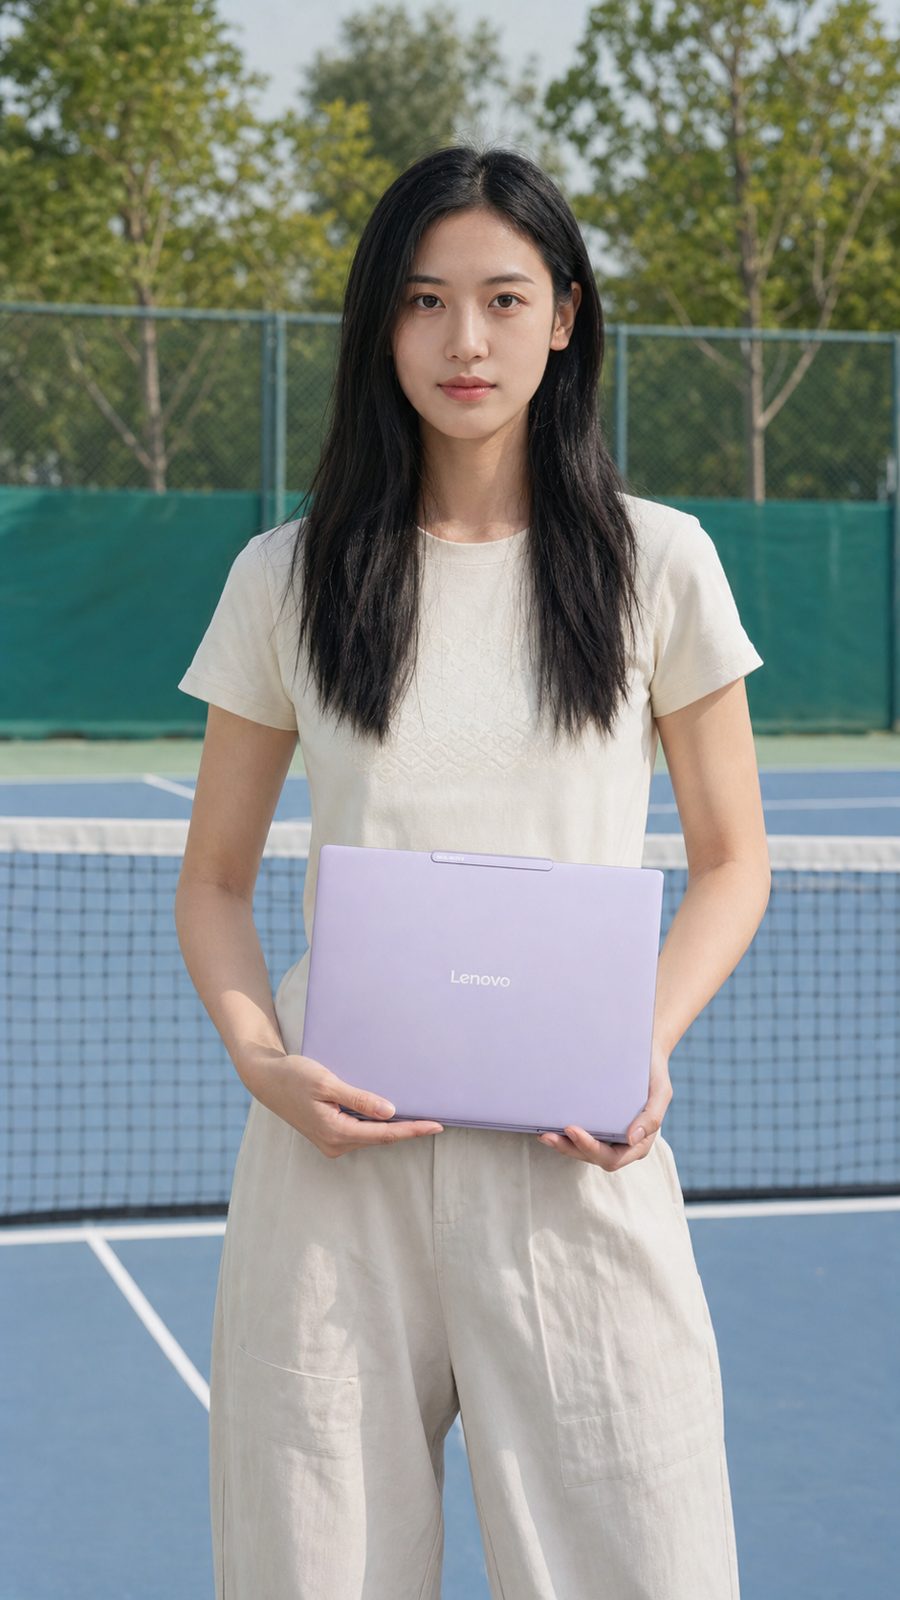
团队在为联想制作产品口播短视频。每条视频都要经过四步:写一段自然的口播脚本、生成数字人手持产品的首帧、按时长把视频切成几段分别生成、再拼接成片。每一步都要懂工具的人来操作,运营同事很难自己完成。
我想解决的是:让第一次用的运营同事不问开发、不猜指令,也能从准备素材一路走到拿到成片。
设计思路
把「对话」当成工作台
运营本来就在飞书群里沟通,所以入口直接放在群里:@Bot,发产品图、人物图和产品资料。之后每一步都在同一个话题里推进,在关键节点等运营确认:选画幅、确认首帧、选脚本,最后把成片回传到原话题。
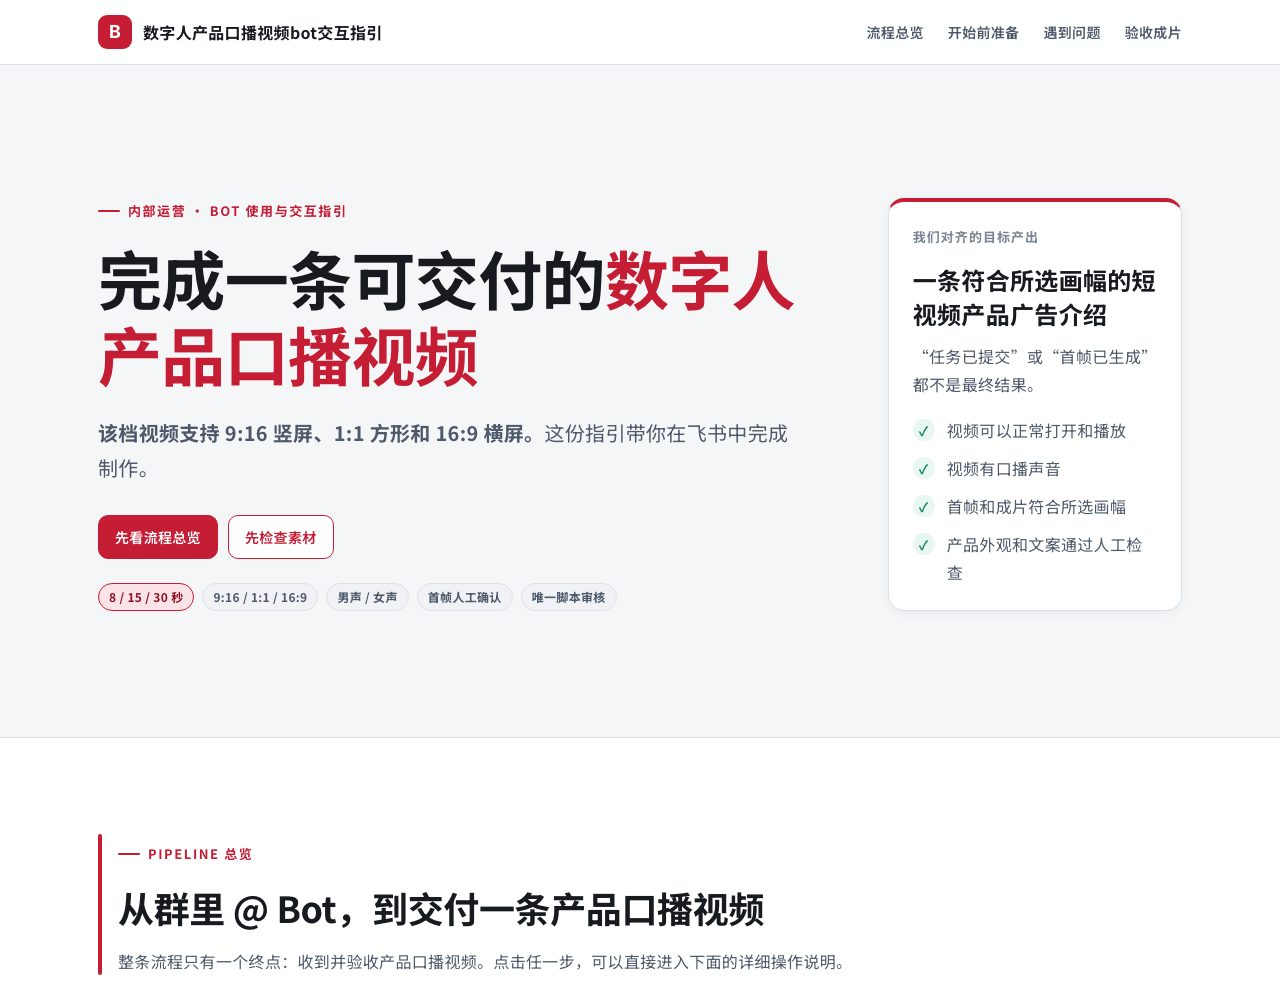
我同时写了一份运营上手指引页面,按「先准备三类素材 → 每一步该回复什么 → 遇到问题怎么办」组织,可以直接复制里面的回复语。
首帧和脚本先确认,再花钱生成视频
视频生成是整条链路里最贵、最慢的一步。所以先让运营确认首帧画面和脚本,确认后才调用视频模型。脚本规则我单独整理成文档并做了版本管理(当前是第 3 版「自然种草」风格),控制口播语气、产品名的读法和每段时长。
长视频分段生成,后台自动拼接
单次视频生成有时长上限,30 秒视频要拆成几段分别生成,再用 FFmpeg 去掉段落间的静音并拼接。分段之间要保持同一人物、同一产品、同一画幅,这部分我用参考素材一致性测试反复验证过。
我做了什么
- 梳理运营真实使用场景,设计 8 步对话流程和每一步的确认点
- 制定口播脚本生成规则,接入 DeepSeek 生成候选脚本
- 接入首帧生成和 Kling 分段视频生成,测试 Bot 改用 MiniMax 控制测试成本
- 为每个模块写自动化测试(共 27 个测试文件),区分生产 Bot 和测试 Bot 的密钥与数据,避免测试误动线上
- 编写 Devbox 部署交接文档和运营上手指引
结果与反思
Bot 已在我的 Mac 上作为团队内部工具运行,累计完成 15 个真实视频任务。迁移到团队服务器的方案已经写好交接文档,下一步需要先把首帧生成改接官方 API。
做完之后我最大的体会是:AI 工作流里难的不是调通模型,而是决定哪些步骤必须让人确认。确认点太少,返工成本高;确认点太多,运营会觉得比原来还麻烦。
用到的工具:飞书长连接 Bot、Node.js、DeepSeek、Kling、MiniMax、FFmpeg、Codex